Questo progetto è nato da una domanda che non ha nulla a che fare con gli app store. Quando ho scritto la tesi, usare l’AI generativa era sconsigliato, il che in pratica significava non usarla. ChatGPT era pubblico da circa due mesi e nessuno contestava la regola.
Tre anni dopo, quella stessa regola sembra quasi impossibile da far rispettare e ancora più difficile da giustificare. Farei fatica a trovare uno studente che non si faccia aiutare dall’AI per la tesi, e ancora più fatica a sostenere che non dovrebbe farlo. È questo ribaltamento, non la letteratura sugli app store, che mi ha spinto a riaprire il mio lavoro quest’anno. Non volevo riscriverlo. Volevo vedere cosa sarebbe emerso da una seconda lettura, più scettica, di qualcosa a cui avevo dato fiducia per tre anni senza più toccarlo.
Ogni grafico e ogni numero qui sotto provengono da uno script nel repository della revisione.
Nel febbraio 2023 ho consegnato una tesi su una domanda circoscritta: quando una persona arriva sulla pagina di un’app nello store, cosa la convince a installarla? Ho studiato tre elementi: il voto medio delle recensioni, il numero di download e il brand dello sviluppatore, espresso dal nome dell’app, dall’icona e dal nome dello sviluppatore. Ho modificato gli screenshot di una vera pagina del Play Store per ottenere una versione forte e una debole di ciascun elemento. Ogni partecipante vedeva tre pagine, una per elemento, in ordine casuale, ciascuna con una delle due versioni estratta a caso. Nessuno vedeva entrambe le versioni dello stesso elemento. Poi misuravo quella che la letteratura chiama intenzione di download.
La conclusione pubblicata era questa: il brand conta di più, la reputazione viene seconda e la popolarità non fa praticamente nulla, almeno in una categoria con scarsi effetti di rete.
Quest’anno ho riaperto i file. I dati hanno retto: la randomizzazione funzionava, non ci sono valori mancanti e ogni regressione della tesi si riproduce fino alla quarta cifra decimale. L’analisi, invece, non ha retto. Avevo commesso tre errori, nessuno nei dati. Tutti e tre riguardavano quello che ne avevo fatto.
Primo errore: tre regressioni non bastano per un confronto
La conclusione principale nasceva dall’accostamento di tre coefficienti: 1,53 per il brand, 0,50 per la reputazione, 0,36 per la popolarità. Il brand è chiaramente il più grande. Fine.
Peccato che quei numeri provenissero da tre regressioni diverse, su tre gruppi diversi di partecipanti. La tesi non verifica mai se 1,53 differisca da 0,50. Ho guardato i due numeri e ho tratto la conclusione.
Ho quindi eseguito il test che avrei dovuto fare dall’inizio: un unico modello su tutte le 1.473 risposte, tenendo conto del fatto che ogni persona ne forniva tre.
| Elemento | Effetto sull’intenzione di download (scala 1–7) | IC al 95% |
|---|---|---|
| Brand dello sviluppatore | +1,05 | da 0,81 a 1,29 |
| Reputazione (voto) | +0,85 | da 0,61 a 1,09 |
| Popolarità (download) | +0,22 | da −0,02 a 0,46 |
Nella media dei tre giudizi espressi da ciascuno, brand e reputazione non sono distinguibili (p = 0,24). Entrambi superano chiaramente la popolarità. La mia gerarchia a tre livelli è in realtà a due, almeno in quella media, e la precisazione conta.
La parte interessante è quanto mi sia costata la frammentazione. Dividere un campione in nove sottocampioni ha disperso gran parte della potenza statistica che avevo raccolto. L’effetto della reputazione è aumentato di due terzi, da 0,50 a 0,85. Circa metà dell’aumento dipende dalla precisione: sulla stessa domanda relativa alla prima app, un unico modello su tutti i dati stima 0,68, non 0,50. L’altra metà deriva da una domanda diversa, perché la reputazione acquista forza nei giudizi successivi.
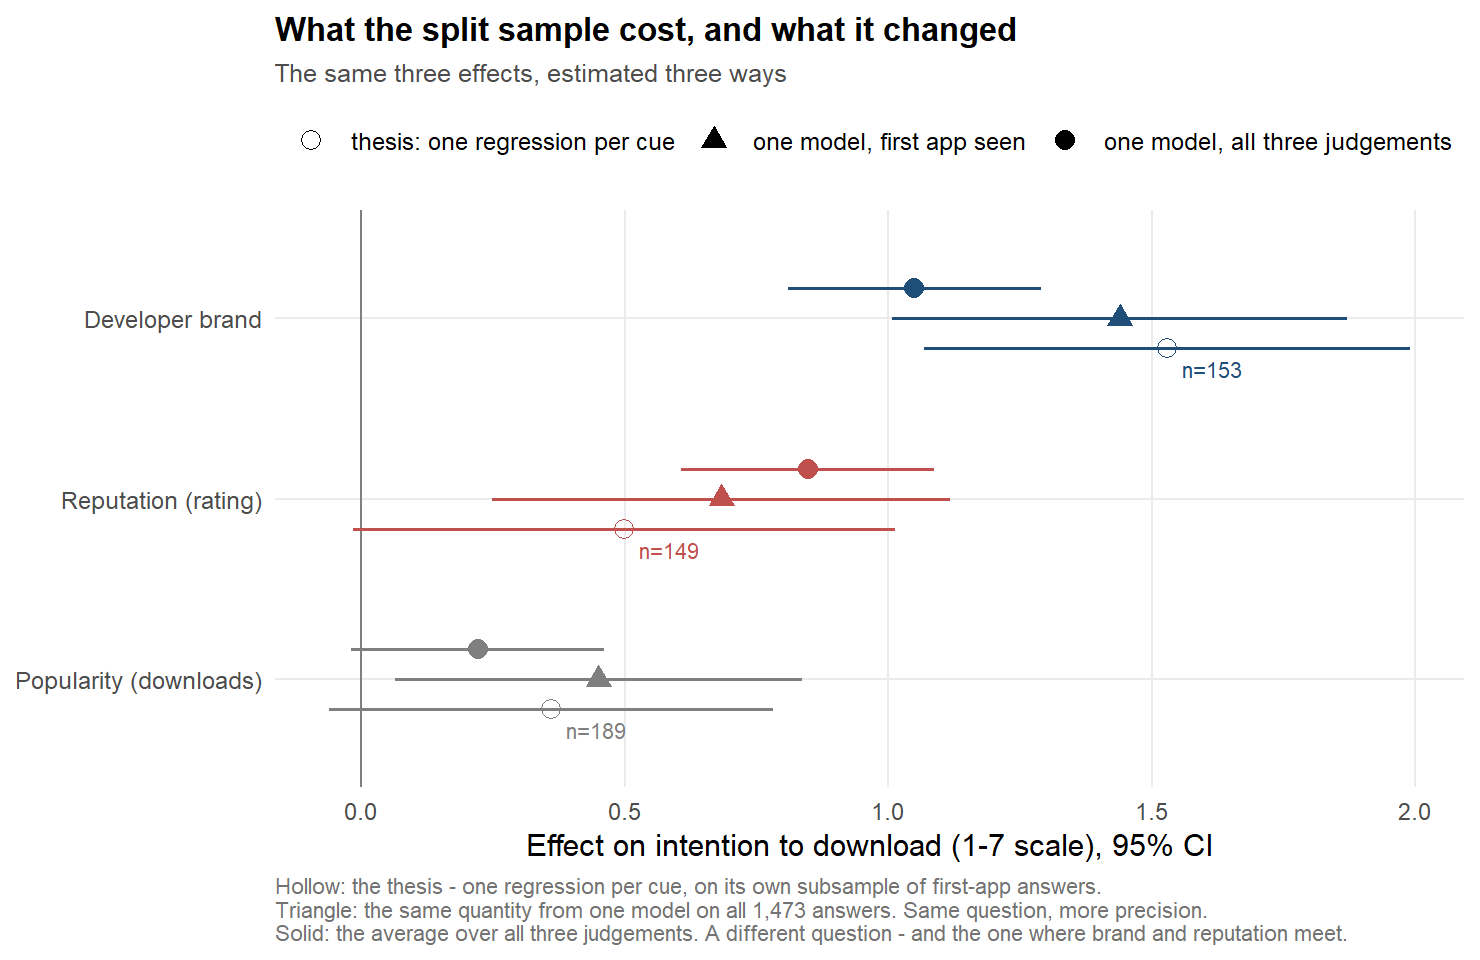
Gli stessi tre effetti, stimati in tre modi. Punti vuoti: la tesi, una regressione per elemento sul proprio sottocampione. Triangoli: la stessa domanda, sulla prima app, con un modello unico. Punti pieni: la media dei tre giudizi, che risponde a una domanda diversa.
Non volevo fidarmi ciecamente del mio nuovo modello preferito, quindi ho ripetuto il confronto in tutti i modi difendibili: 24 combinazioni di campione, tipo di modello e controlli. Una non convergeva e l’ho esclusa. Il brand risulta superiore in 4 delle 23 rimaste. Non sono quattro risultati casuali: sono esattamente quelli che usano soltanto la prima app vista da ogni partecipante.
Non è una coincidenza. Nel 2022 avevo scelto la prima app di proposito, perché la prima schermata è l’unica che si giudica senza avere ancora nulla con cui confrontarla. Su quella quantità, quella per cui era stato costruito il disegno sperimentale, il brand supera effettivamente la reputazione: +0,76 punti, p = 0,03, e +1,02 (p = 0,007) nel campione effettivamente usato dalla tesi.
La conclusione principale, quindi, non era un artefatto. La tesi, però, faceva due affermazioni: il brand vince sulla prima app e perde il vantaggio dopo che l’utente ne ha viste altre. Non ne verificava nessuna. Ora il test c’è. La prima regge (+0,76, p = 0,03). La seconda non raggiunge la significatività (p = 0,10): i dati mostrano una tendenza, non un cambiamento dimostrato.
L’errore è più circoscritto di «la classifica crolla», ma più difficile da liquidare. Nove regressioni su nove sottocampioni non condividono parametri. Questo significa che non era possibile verificare alcun confronto tra i tre elementi, e infatti non ne è stato verificato nessuno. Un unico modello su tutte le 1.473 risposte restituisce la stessa stima per la prima app, più il test che mancava nella tesi, più ciò che succede dopo aver visto le alternative.
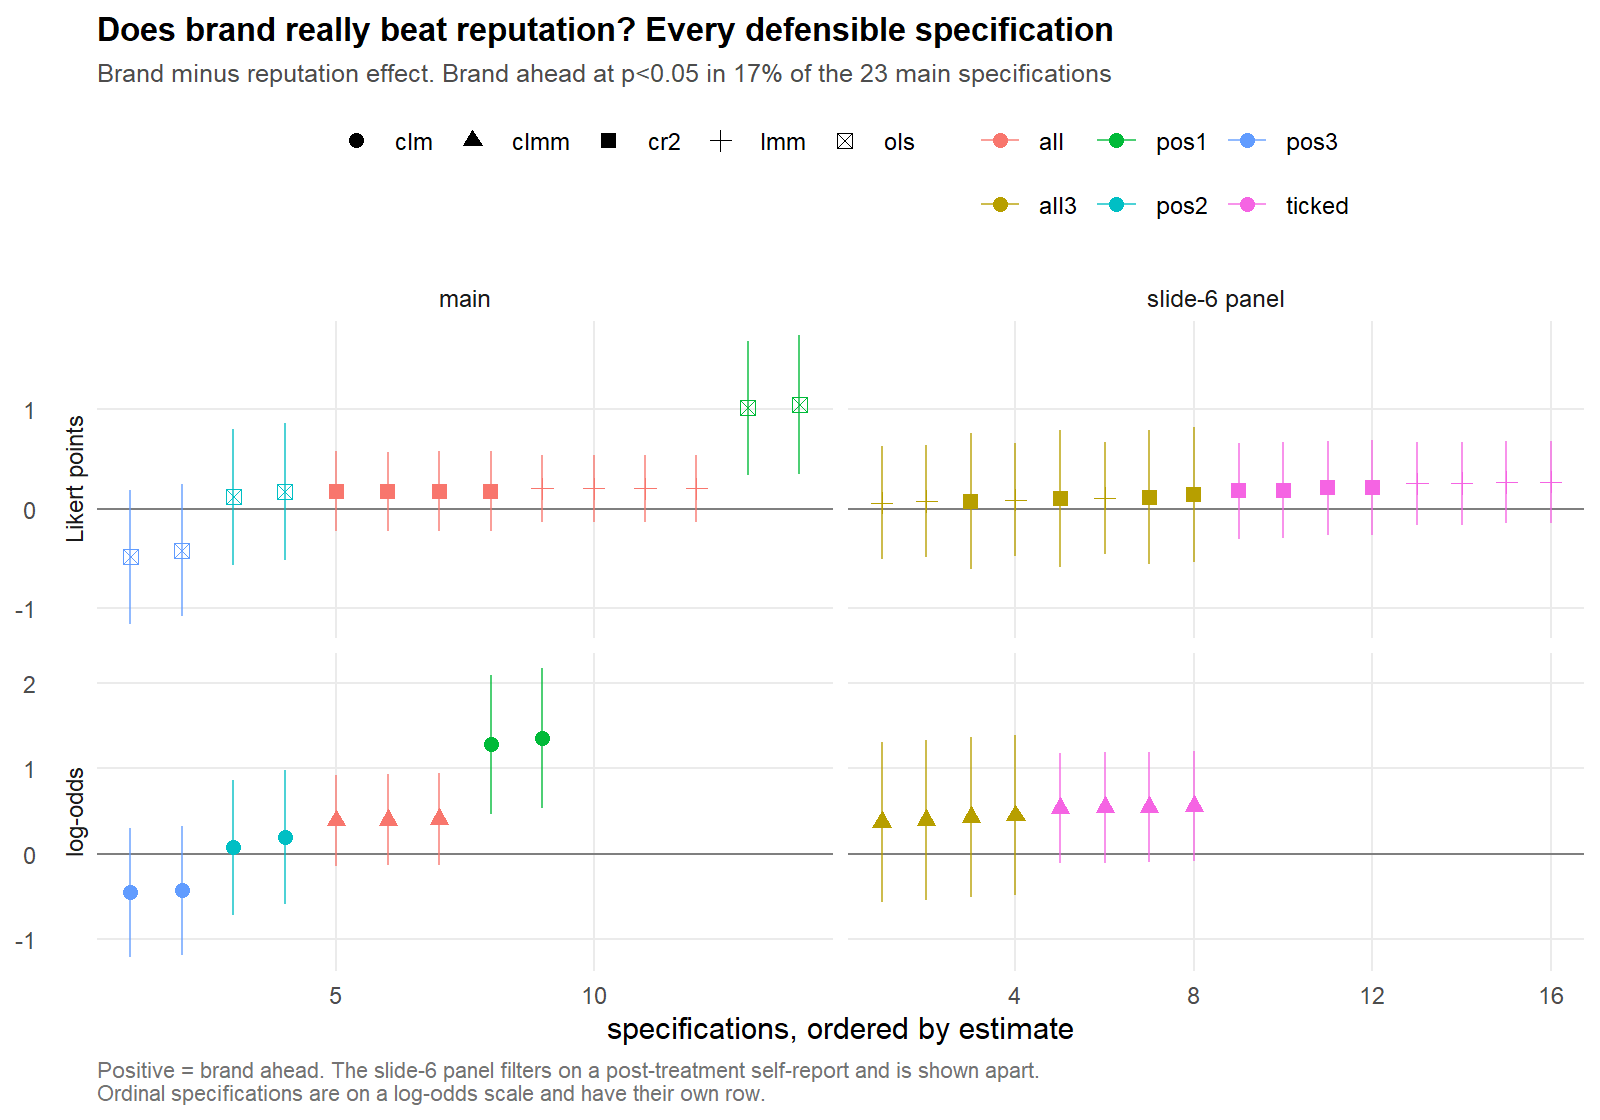
Ogni specificazione difendibile dello stesso confronto. Il brand vince chiaramente solo dove mirava il disegno: sulla prima app vista. Negli altri casi brand e reputazione non sono distinguibili.
Secondo errore: il mio «manipulation check» non lo era
Il risultato che gli altri mi ripetevano era quello controintuitivo: il numero di download non conta. In un mercato ossessionato dalle installazioni, è una frase che colpisce. Non è però esattamente ciò che sostenevo. Avevo usato app scanner perché hanno scarsi effetti di rete: uno scanner non diventa più utile perché lo usano milioni di altre persone. Il numero di download può quindi segnalare ciò che pensano gli altri, ma non promettere un valore aggiuntivo. La mia affermazione era che la popolarità fosse inefficace in quel contesto.
Non penso più che i dati sostengano nemmeno questo. Per due ragioni. Una avrei dovuto vederla nel 2022. L’altra l’avevo vista, ma non ne avevo tratto le conseguenze.
La prima è imbarazzante. Sono tornato alle immagini usate come stimolo. La versione a bassa popolarità mostra 10.000+ download accanto a 84.000 recensioni. Più recensioni che download. È impossibile. Il numero di recensioni era uguale nelle due condizioni: il difetto riguarda quindi soltanto la versione debole, proprio quella su cui si reggeva il confronto.
La seconda è più sottile e riguarda l’etichetta, più che l’analisi. La tesi riporta, modello per modello, un manipulation check: la quota di partecipanti che confermava di aver notato ogni elemento. In realtà avevo chiesto, una sola volta e alla fine, quali fattori hai preso in considerazione?, con nove caselle da selezionare. Non verifica che la manipolazione sia stata percepita: raccoglie il racconto a posteriori di ciò che le persone pensano di aver fatto.
Lo sapevo già allora. La tesi definisce la domanda «una versione di compromesso, e non ideale». La scelta successiva era deliberata: misurarla, riportarla, non condizionarvi alcuna analisi. Era la scelta giusta e la rifarei. Quello che non ho fatto è esplicitarne la conseguenza. Uno studio in cui l’unica misura della percezione è un’autodichiarazione successiva al trattamento non verifica che qualcuno abbia visto la manipolazione. La parola check, ripetuta in nove tabelle, suggerisce silenziosamente il contrario.
A pagarne il prezzo è soprattutto la popolarità, perché è lì che una verifica della percezione sarebbe servita di più. Tra il 60% che ha selezionato «numero di download», l’effetto della popolarità più che raddoppia, fino a +0,49, e diventa significativo. Lo propongo come esempio, non come correzione, perché il confronto è quasi circolare: chi è influenzato dai download è anche più propenso a dire di averli guardati. Resta il fatto che, tra uno stimolo difettoso e una misura dell’attenzione non verificabile, il risultato nullo aveva meno sostegno di quanto gli avessi attribuito.
Cosa resta, allora, della popolarità? Prima di guardare i risultati ho fissato il più piccolo effetto rilevante nella pratica. Ogni modo ragionevole di ricavarlo porta tra 0,26 e 0,33 punti della scala. Rispetto a quella soglia:
- sulla prima app vista, senza alternative già osservate, la popolarità funziona: +0,45, e l’effetto è effettivo;
- sulla seconda è −0,22 e sulla terza +0,40. Entrambi i risultati sono inconcludenti. Gli intervalli oltrepassano la soglia in entrambe le direzioni: non posso distinguere «nessun effetto» da «troppo piccolo per contare», né da un effetto piuttosto grande.
All’inizio avevo riassunto il secondo punto con un unico numero, +0,07 dopo il confronto, usando un modello che tratta seconda e terza app come un’unica condizione. È lo stesso genere di errore che avevo appena criticato nella tesi: comprimere −0,22 e +0,40 in un numero descrive una situazione che nessuno ha vissuto. Inoltre assecondava una storia ordinata che mi piaceva, perché la terza app non è distinguibile dalla prima: differenza di 0,05, p = 0,86. Il calo riguarda soltanto la seconda e nessuna differenza tra posizioni supera la correzione per averle esaminate tutte e tre.
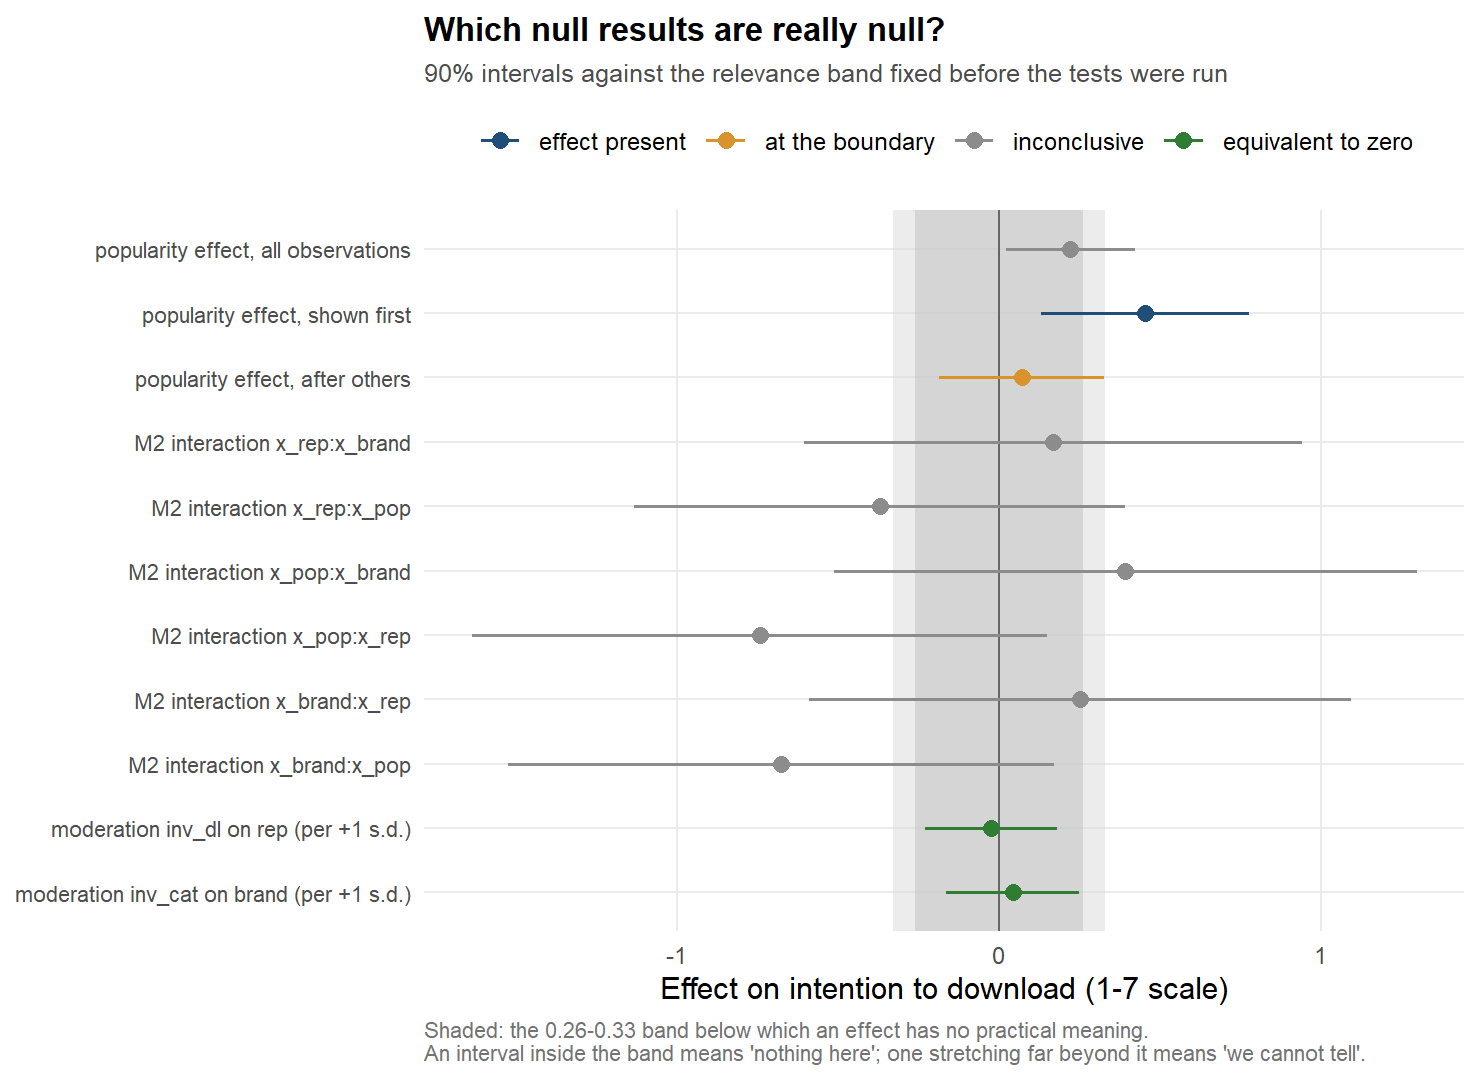
Quali risultati nulli sono davvero nulli. La fascia indica l’irrilevanza pratica, fissata prima dei test. Un intervallo molto più ampio della fascia significa che lo studio non riusciva a vedere, non che non ci fosse nulla da vedere.
«Il numero di download non conta» era troppo forte. Quello che posso difendere è più limitato e meno memorabile: dove gli effetti di rete sono bassi, i download influenzano l’intenzione sulla prima app vista; dopo, questo studio non sa dirlo. È comunque abbastanza per ritirare la conclusione che avevo pubblicato.
Terzo errore: il silenzio non è una prova
La tesi conclude che non ci sia interazione tra i tre elementi. Per ogni schermata ne veniva modificato uno solo, quindi qui «interazione» può significare soltanto qualcosa di più ristretto: l’effetto del voto di questa app dipende dal brand di un’app vista prima? La sezione metodologica riconosce questo limite. L’abstract no.
Il problema più profondo è che, comunque, la risposta non dice nulla. Il disegno avrebbe potuto rilevare soltanto interazioni di 1,3–1,5 punti sulla scala a sette punti: tanto quanto gli stessi effetti principali, compresi tra 0,2 e 1,0, mentre le interazioni sono solitamente molto più piccole. Non trovarle non dimostra che non esistano. Lo strumento era troppo grossolano per vederle.
I due risultati di moderazione su cui avevo costruito consigli manageriali sono il caso opposto. Qui i dati possono dire più di «non significativo»: entrambi gli effetti rientrano nel margine che avevo fissato in anticipo come troppo piccolo per contare. Non sono semplicemente indimostrati: sono praticamente assenti.
Cosa regge e una cosa nuova
L’effetto del brand supera ogni controllo. Degli 81 coefficienti stimati in nove regressioni, esattamente due sopravvivono alla correzione per il numero di test, ed entrambi sono l’effetto del brand.
Brand e reputazione hanno la stessa forza soltanto in media. Separando le posizioni nella sequenza, il quadro è più preciso di quanto sostenessi all’inizio:
| Prima app vista | Seconda | Terza | |
|---|---|---|---|
| Brand dello sviluppatore | +1,44 | +0,88 | +0,92 |
| Reputazione | +0,68 | +0,63 | +1,13 |
| Popolarità | +0,45 | −0,22 | +0,40 |
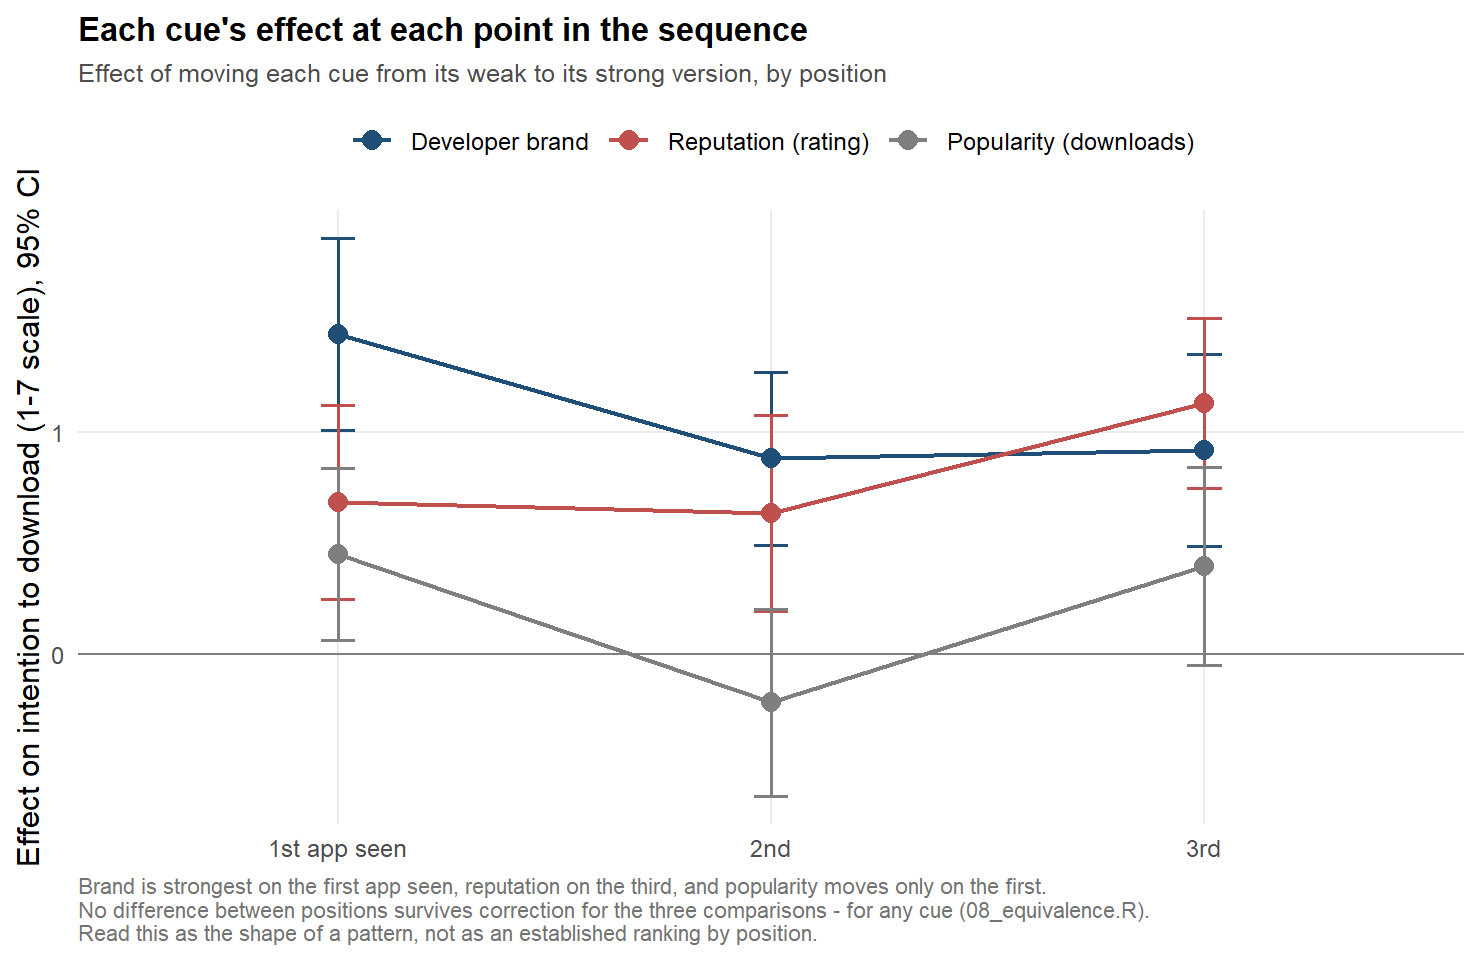
Effetti nelle tre posizioni della sequenza, con intervalli al 95%. Il brand è più forte sulla prima app, la reputazione sulla terza, ma nessuna differenza tra posizioni supera la correzione per confronti multipli. È il profilo di un andamento, non un andamento dimostrato.
Il brand domina quando non c’è ancora nulla con cui confrontarsi. È il divario che la tesi aveva trovato, e regge. Dopo aver visto alternative, i due convergono: 0,89 contro 0,92, in un modello che tratta ciò che viene dopo la prima app come un’unica condizione anziché due. In termini probabilistici, il brand supera la reputazione con probabilità del 99% prima del confronto e del 48% dopo: un lancio di moneta. I dati non dimostrano però che le due situazioni differiscano tra loro (p = 0,10), e per nessuno dei tre elementi una differenza a coppie tra posizioni supera la correzione. Quel movimento è quindi il profilo di qualcosa che merita un test adeguato. Non è un risultato dimostrato.
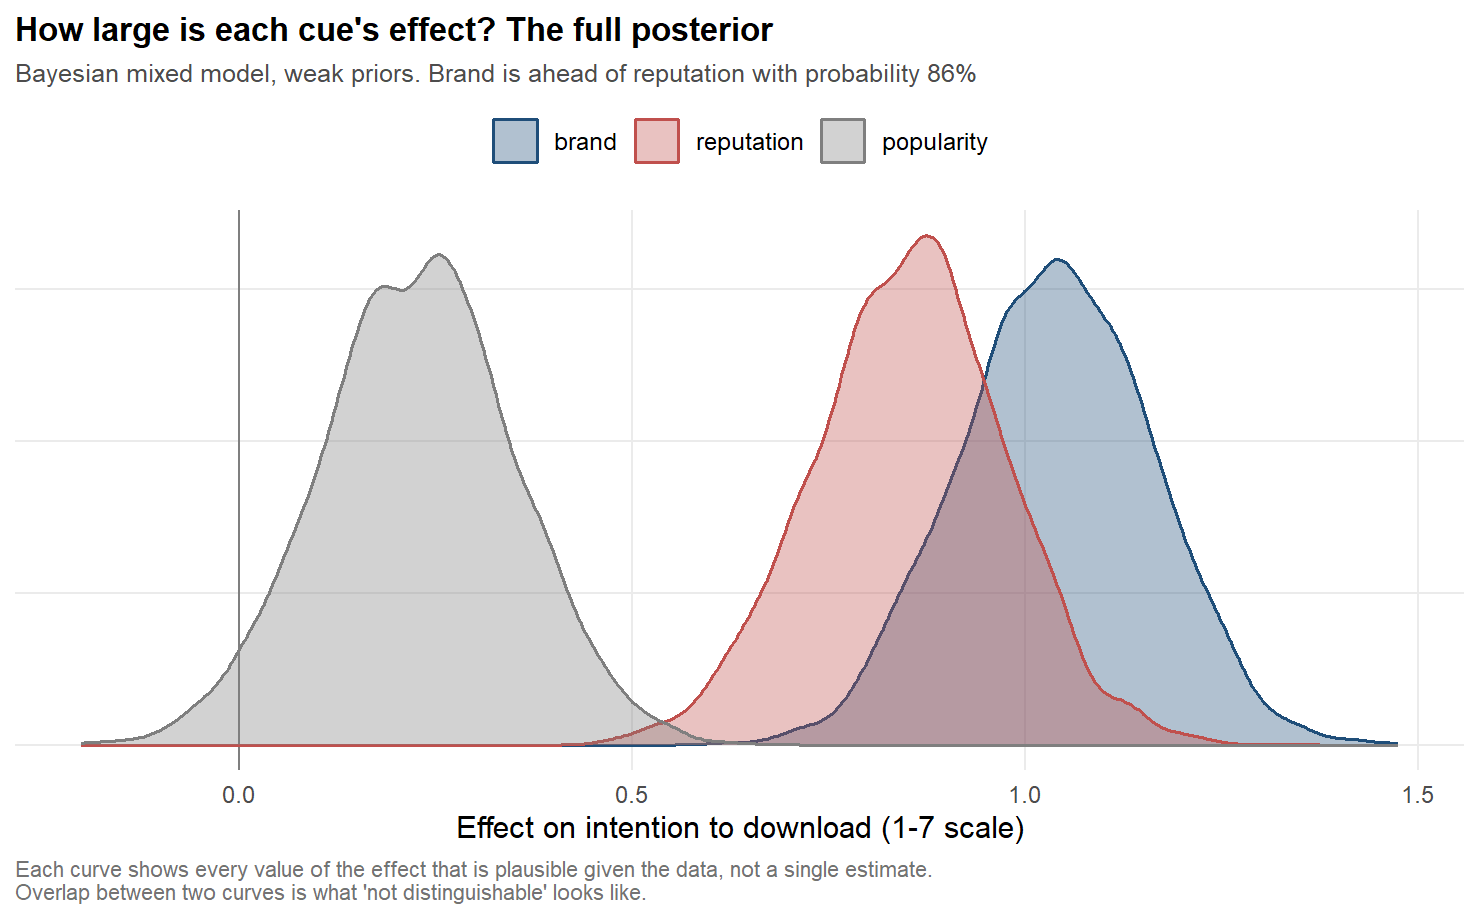
La grandezza plausibile degli effetti alla luce dei dati. Quando le curve si sovrappongono, i dati non distinguono i due elementi: ecco cosa significa non distinguibili.
Una lettura pratica c’è, ma regge solo se regge quel profilo. Un brand forte vale di più quando l’utente non sta confrontando alternative: un collegamento da una ricerca, una pubblicità, un consiglio. I voti diventano preziosi quando si esplora e si confronta. Per un nuovo concorrente è una notizia migliore di quanto sembri: non puoi comprarti il brand di Adobe, ma puoi essere l’app che supera il confronto.
Poi c’è un risultato davvero nuovo, che prima di eseguire l’analisi avevo previsto per iscritto non sarebbe emerso. Le persone differiscono molto per quanto sono influenzate da questi elementi, e la differenza è sistematica. Chi è in generale più propenso a scaricare app è meno influenzato da ciò che mostra la pagina: correlazione −0,59. I segnali funzionano sugli indecisi. Una media complessiva lo nasconde del tutto.
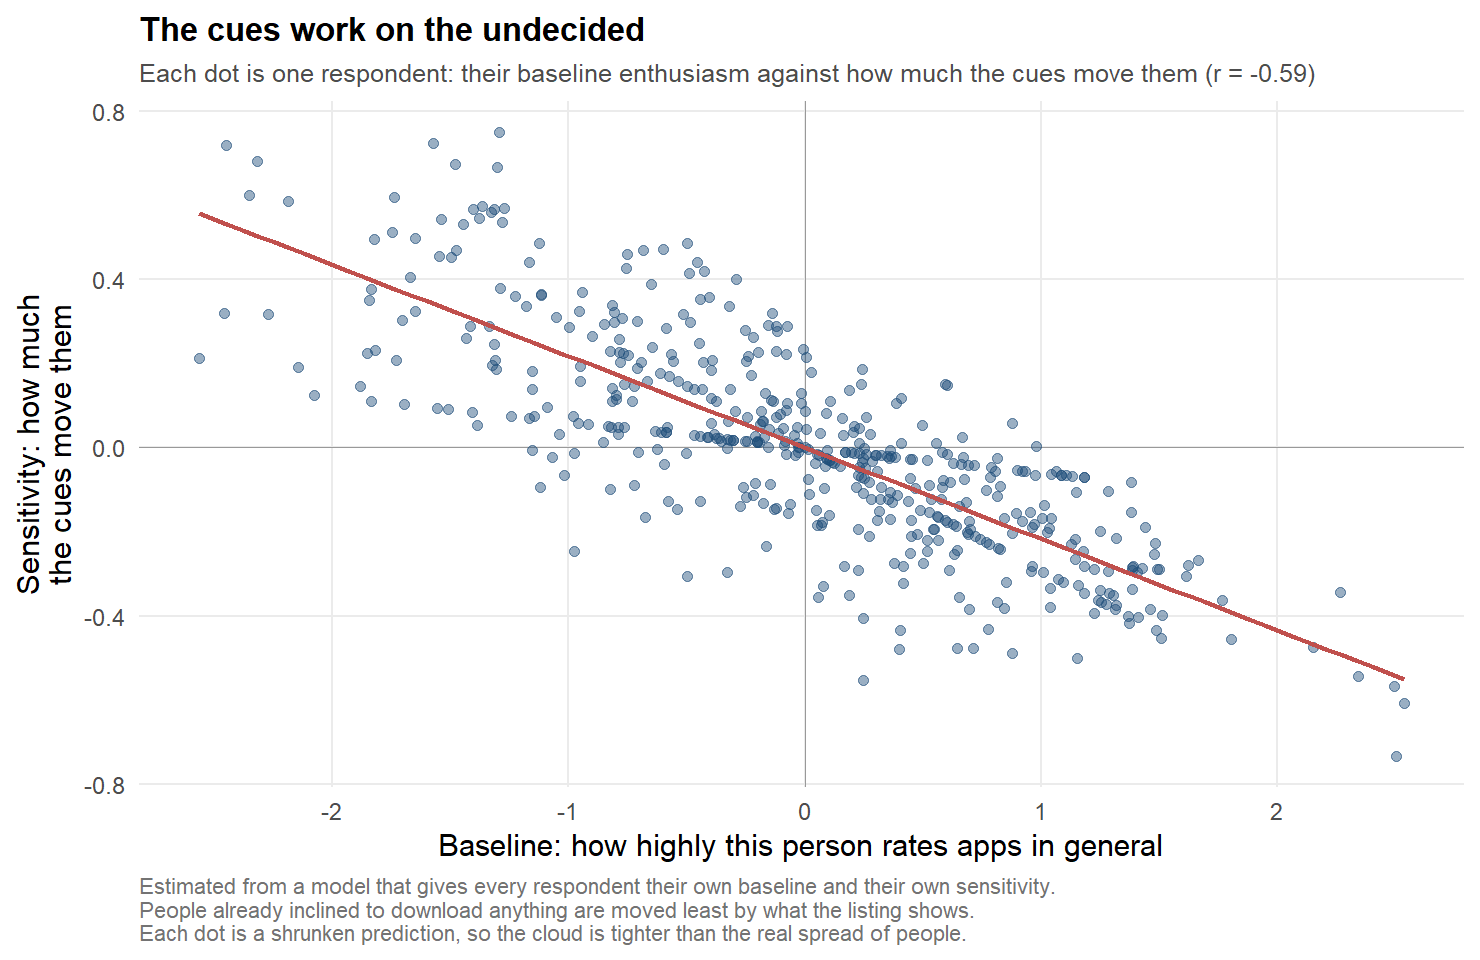
Un punto per partecipante: propensione di base al download e sensibilità agli elementi della pagina. I segnali funzionano sugli indecisi. I punti sono previsioni del modello, riportate verso la media quando il partecipante fornisce poche informazioni.
Quattro controlli che non hanno cambiato nulla
Una nuova analisi vale quanto i controlli che avrebbero potuto metterla in difficoltà. Quattro non ci sono riusciti.
Le persone non trattano una scala da 1 a 7 come un righello. La risposta 6 copre un intervallo dell’intenzione sottostante quasi doppio rispetto alla risposta 3: anche chi è piuttosto sicuro si ferma un passo prima del massimo, evitando gli estremi della scala. Ho ristimato tutto senza assumere distanze uguali. Gli effetti sono cambiati di 0,7–3,0 punti percentuali e la graduatoria è rimasta la stessa.
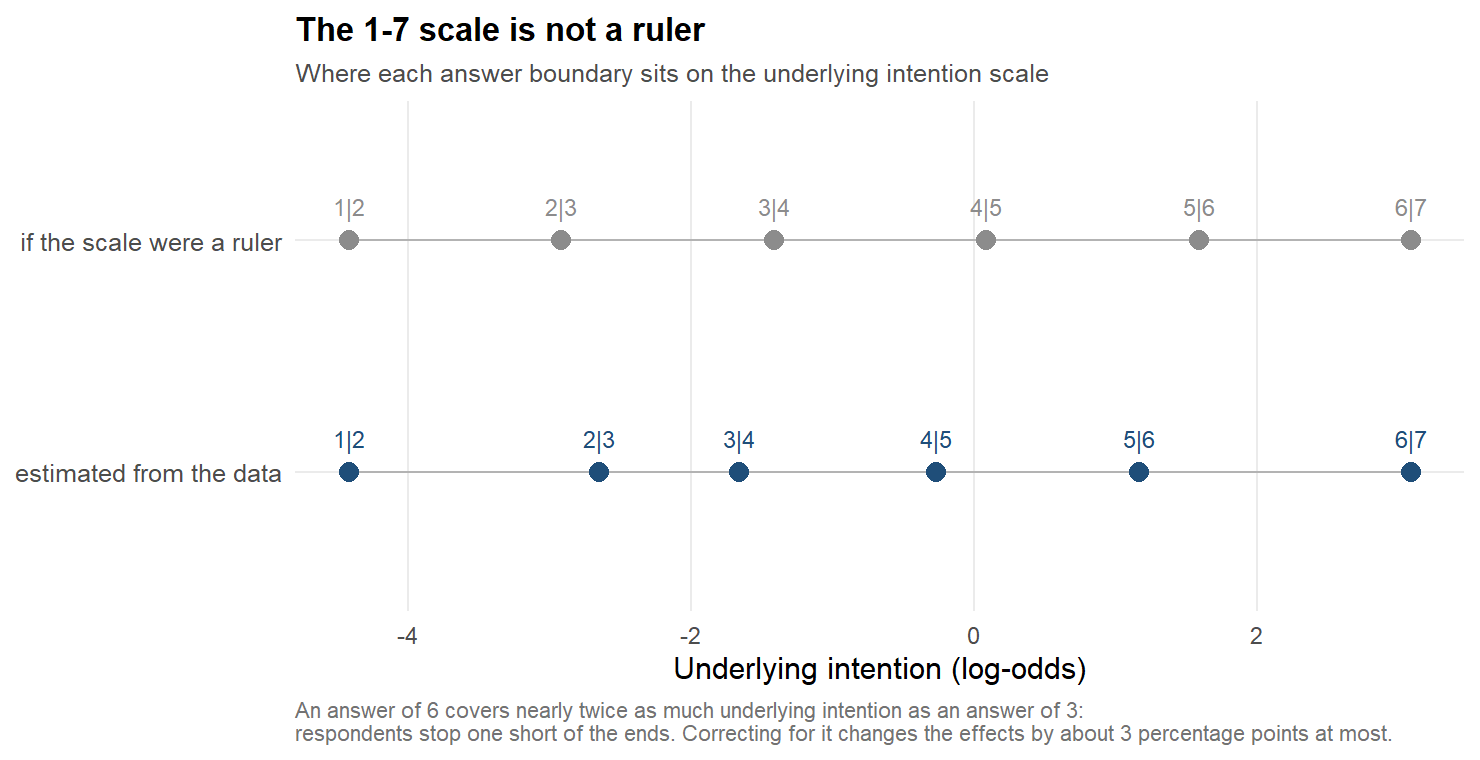
Dove si collocano le soglie delle risposte sulla scala dell’intenzione sottostante, rispetto a una scala con distanze uniformi.
Gli effetti non dipendono in modo rilevabile da chi risponde: né età, né genere, né istruzione, né occupazione. Gli studenti rispondono alla reputazione circa il doppio degli occupati. È una storia ordinata, ma non supera il proprio test. Con un campione composto al 69% da studenti, non avrebbe potuto superarlo.
Escludere i 33 partecipanti che hanno risposto troppo in fretta o dato la stessa risposta a un’intera scala fa aumentare leggermente tutti gli effetti, come ci si aspetta eliminando rumore. Non cambia altro.
Infine, i grafici della tesi non usano le risposte grezze da 1 a 7, ma una versione centrata sulla media, sottraendo una costante per ogni elemento. Non è un problema se il modello sa già quale gruppo sta osservando, e il mio lo sapeva: ristimando sulle risposte grezze, nessun coefficiente cambia di più di 0,00000000005. Per il lettore, però, un costo c’è. Le altezze delle tre linee non sono confrontabili, solo le pendenze lo sono, e in quattro pannelli su sei la versione centrata ordina i tre elementi diversamente da quella grezza. Avevo letto una pendenza, quindi la conclusione regge. In un disegno a misure ripetute sarebbe invece stato importante centrare per partecipante, non per elemento. Non basta sottrarre una media: occorre includere il partecipante nel modello, proprio ciò che mancava alla mia ANOVA. Farlo nel modo sbagliato, per sottrazione, avrebbe ridotto ogni effetto di circa un terzo.
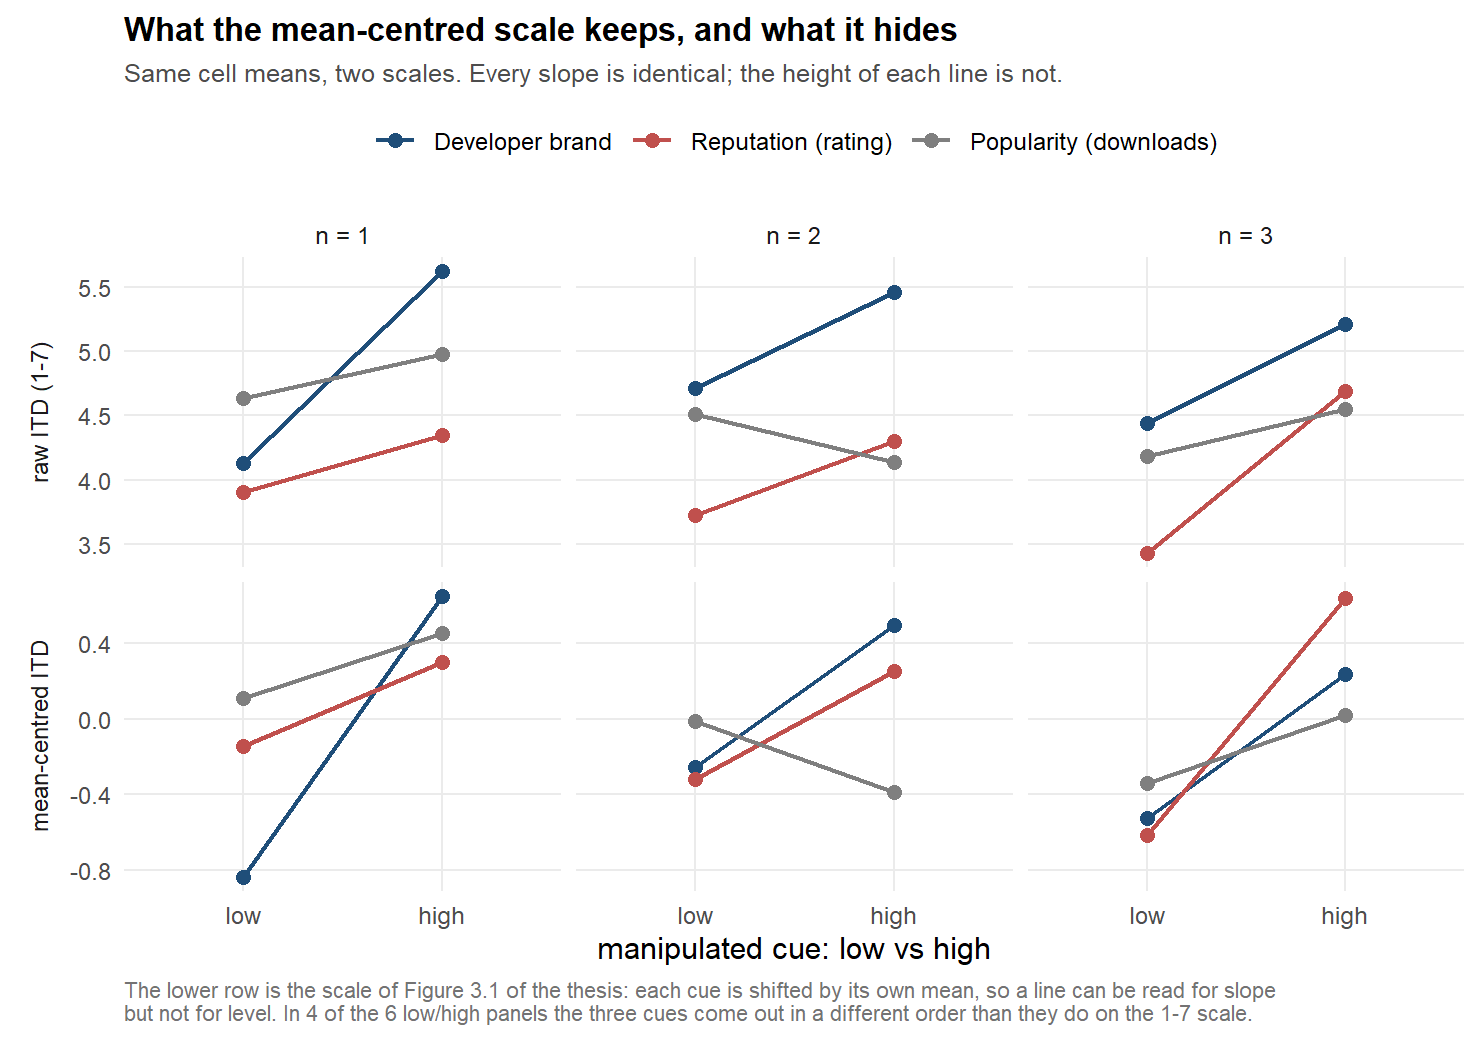
Le stesse medie sulla scala grezza e sulla scala centrata usata nei grafici della tesi. Le pendenze sono identiche. L’ordine delle tre linee no.
Cosa mi hanno insegnato tre anni di distanza
Tre cose, nessuna sugli app store.
Proteggere la quantità che si vuole stimare e dividere il campione sono cose diverse: ho fatto la seconda pensando di fare la prima. Misurare soltanto la prima app vista era l’intuizione giusta: è l’unico giudizio espresso prima di avere qualcosa con cui confrontarsi. Stimarlo con nove regressioni scollegate era sbagliato, perché regressioni senza parametri condivisi non consentono quel confronto, ed è esattamente il confronto che ho fatto. Ho enunciato entrambe le metà del risultato senza verificarne nessuna.
«Non significativo» non è un risultato finché non dici cosa avresti potuto rilevare. Ogni risultato nullo che ho riportato meritava una frase sul più piccolo effetto che il disegno era in grado di vedere. Tre si dissolvono davanti a quella domanda.
Riguarda gli stimoli. Il problema peggiore del progetto, uno screenshot con più recensioni che download, non era nei modelli né nei dati. Era in un’immagine che nel 2022 avevo guardato cento volte senza controllarla davvero.
Una nota su come ho lavorato. La nuova analisi si è avvalsa dell’AI. Era nata da una piccola curiosità: come avrebbe scritto un’AI la mia tesi magistrale? La risposta era meno interessante della domanda a cui ha portato: come l’avrebbe revisionata? Non ha trovato nulla che non avrei potuto trovare da solo nel 2023. Ha fatto l’unica cosa che non avevo fatto: verificare ogni affermazione rispetto alle prove che avevo già, comprese quelle che facevano comodo. È una soglia bassa e la prima volta non l’ho superata.
Nel 2023 avevo usato l’AI soltanto per controllare la grammatica inglese. Quest’anno lo stesso tipo di strumento mi ha aiutato a smontare e ricostruire l’analisi in meno di due settimane. Nessuno dei tre errori richiedeva una macchina: una calcolatrice e un po’ di pazienza li avrebbero individuati già nel 2022. Mancava la decisione di dubitare di qualcosa in cui credevo già. E quella decisione resta mia.
L’AI accelera l’esecuzione: ripetere ventiquattro specificazioni richiede pochi minuti. Il giudizio, capire se un risultato nullo sia davvero nullo o se un risultato comodo resista al dubbio, continua alla velocità di sempre. Il rischio è confondere le due velocità. Ho scritto questo articolo con lo stesso tipo di aiuto, quindi merita lo stesso esame critico. Se nasconde un quarto errore, vorrei saperlo.
Revisione completa, codice, regole decisionali fissate in anticipo e log sono nel repository della revisione; tesi originale, dati e codice sono qui.